Szkolenia Big Data na żywo z instruktorem, prowadzone online lub stacjonarnie, rozpoczynają się od wprowadzenia do podstawowych pojęć Big Data, a następnie przechodzą do języków programowania i metodologii wykorzystywanych do analizy danych. Narzędzia i infrastruktura umożliwiające przechowywanie danych Big Data, przetwarzanie rozproszone i skalowalność są omawiane, porównywane i wdrażane podczas praktycznych sesji demonstracyjnych.
Szkolenia Big Data są dostępne w formie „szkolenia online na żywo” lub „szkolenia stacjonarnego na żywo”. Szkolenie online na żywo (zwane też „zdalnym szkoleniem na żywo”) odbywa się za pośrednictwem interaktywnego pulpitu zdalnego. Szkolenie stacjonarne na żywo może być prowadzone lokalnie w siedzibie klienta w Koszalin lub w korporacyjnych centrach szkoleniowych NobleProg w Koszalin.
NobleProg -- Twój lokalny dostawca szkoleń
Koszalin
Gwardia, Sportowa 34, Koszalin, Polska, 75-503
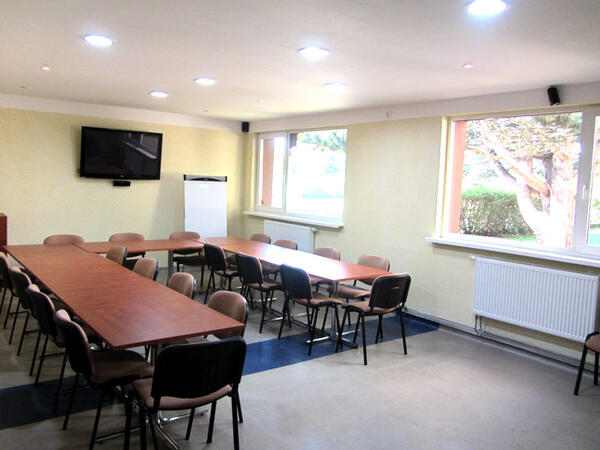
Sala szkoleniowa jest wyposażona w nowoczesne udogodnienia. Znajduje się 3 kilometry od centrum miasta. Obiekt posiada przestronny parking dla uczestników szkoleń, co zapewnia wygodny dostęp dla wszystkich kursantów.
To szkolenie prowadzone przez instruktora, na żywo w Koszalin (online lub na miejscu) jest skierowane do średnio zaawansowanych naukowców zajmujących się danymi oraz inżynierów, którzy chcą wykorzystać Google Colab i Apache Spark do przetwarzania i analizy dużych zbiorów danych.
Po zakończeniu szkolenia uczestnicy będą mogli:
Skonfigurować środowisko do pracy z dużymi danymi przy użyciu Google Colab i Spark.
Efektywnie przetwarzać i analizować duże zbiory danych za pomocą Apache Spark.
Wizualizować duże zbiory danych w środowisku współpracy.
To prowadzone przez instruktora szkolenie na żywo w Koszalin obejmuje platformę Stratio, ze szczególnym uwzględnieniem modułów Rocket i Intelligence z PySpark. Uczestnicy opanują pozyskiwanie, transformację i zaawansowaną analitykę danych, zdobywając praktyczne umiejętności w zakresie pętli, funkcji UDF i korporacyjnych przepływów pracy z danymi.
To szkolenie na żywo w Koszalin obejmuje koncepcje hurtowni danych, modelowanie wielowymiarowe i projektowanie potoków ETL. Uczestnicy będą budować schematy gwiazdy, optymalizować obciążenia OLAP i wdrażać zarządzanie danymi, zdobywając praktyczne umiejętności potrzebne do tworzenia solidnych systemów analitycznych.
Uczestnicy, którzy ukończą to szkolenie prowadzone przez instruktora w Koszalin, zdobędą praktyczną, rzeczywistą wiedzę na temat Big Data oraz powiązanych technologii, metodologii i narzędzi.
Uczestnicy będą mieli okazję zastosować tę wiedzę w praktyce poprzez ćwiczenia praktyczne. Interakcja w grupie i feedback od instruktora stanowią ważny element zajęć.
Kurs rozpoczyna się od wprowadzenia do podstawowych pojęć Big Data, następnie przechodzi do języków programowania i metodologii używanych do analizy danych. Na koniec omawiamy narzędzia i infrastrukturę umożliwiające przechowywanie Big Data, przetwarzanie rozproszone i skalowalność.
To szkolenie na żywo w Koszalin pomaga użytkownikom na poziomie średnio zaawansowanym i zaawansowanym opanować architekturę Greenplum i modelowanie danych. Uczestnicy nauczą się projektować tabele rozproszone, stosować wydajny SQL i interpretować plany EXPLAIN w celu optymalnego wykonywania zapytań w wielkoskalowych środowiskach analitycznych.
To prowadzone przez instruktora szkolenie w Koszalin obejmuje instalację Greenplum, aktualizacje i zarządzanie bibliotekami. Uczestnicy uczą się konfigurować klastry, bezpiecznie stosować poprawki i obsługiwać rozszerzenia do zaawansowanej analityki, zdobywając praktyczne umiejętności przydatne w rzeczywistych środowiskach.
To szkolenie prowadzone przez instruktora, na żywo w Koszalin (online lub na miejscu), jest skierowane do zaawansowanych specjalistów ds. danych, którzy chcą optymalizować przepływy pracy związane z przetwarzaniem danych, zapewnić integralność danych oraz wdrażać solidne rozwiązania typu data lakehouse, zdolne poradzić sobie ze złożonością współczesnych aplikacji big data.
Po zakończeniu szkolenia uczestnicy będą mogli:
Zdobyć dogłębną wiedzę na temat architektury Iceberg, w tym zarządzania metadanymi i układu plików.
Skonfigurować Iceberg w celu uzyskania optymalnej wydajności w różnych środowiskach i zintegrować go z wieloma silnikami przetwarzania danych.
Zarządzać tabelami Iceberg na dużą skalę, wprowadzać złożone zmiany schematów i zarządzać ewolucją partycji.
Opanować techniki optymalizacji wydajności zapytań i efektywności skanowania danych dla dużych zbiorów danych.
Wdrożyć mechanizmy zapewniające spójność danych, zarządzanie gwarancjami transakcyjnymi oraz obsługę awarii w środowiskach rozproszonych.
To szkolenie prowadzone przez instruktora, dostępne online lub na miejscu w Koszalin, jest skierowane do profesjonalistów zajmujących się danymi na poziomie początkującym, którzy chcą zdobyć wiedzę i umiejętności niezbędne do efektywnego wykorzystania Apache Iceberg do zarządzania dużymi zbiorami danych, zapewnienia integralności danych i optymalizacji przepływów pracy związanych z przetwarzaniem danych.
Po zakończeniu szkolenia uczestnicy będą mogli:
Zdobyć dogłębną wiedzę na temat architektury, funkcji i zalet Apache Iceberg.
Poznać formaty tabel, partycjonowanie, ewolucję schematów oraz możliwości podróży w czasie.
Zainstalować i skonfigurować Apache Iceberg w różnych środowiskach.
Tworzyć, zarządzać i manipulować tabelami Iceberg.
Zrozumieć proces migracji danych z innych formatów tabel do Iceberg.
To szkolenie prowadzone przez instruktora, na żywo w Koszalin (online lub na miejscu) jest skierowane do specjalistów IT na poziomie średniozaawansowanym, którzy chcą poszerzyć swoje umiejętności w zakresie architektury danych, zarządzania danymi, przetwarzania w chmurze oraz technologii Big Data, aby skutecznie zarządzać i analizować duże zbiory danych w celu migracji danych w swoich organizacjach.
Pod koniec szkolenia uczestnicy będą w stanie:
Zrozumieć podstawowe koncepcje i komponenty różnych architektur danych.
Zdobyć kompleksową wiedzę na temat zasad zarządzania danymi oraz ich znaczenia w środowiskach regulacyjnych.
Wdrażać i zarządzać frameworkami zarządzania danymi, takimi jak Dama i Togaf.
Wykorzystywać platformy chmurowe do efektywnego przechowywania, przetwarzania i zarządzania danymi.
To szkolenie prowadzone przez instruktora na żywo w Koszalin (online lub na miejscu) jest skierowane do inżynierów danych na poziomie średnio zaawansowanym, którzy chcą nauczyć się, jak używać Azure Data Lake Storage Gen2 do efektywnych rozwiązań analitycznych.
Po zakończeniu szkolenia uczestnicy będą mogli:
Zrozumieć architekturę i kluczowe funkcje Azure Data Lake Storage Gen2.
Optymalizować przechowywanie i dostęp do danych pod kątem kosztów i wydajności.
Integrować Azure Data Lake Storage Gen2 z innymi usługami Azure do analizy i przetwarzania danych.
Tworzyć rozwiązania przy użyciu interfejsu API Azure Data Lake Storage Gen2.
Rozwiązywać typowe problemy i optymalizować strategie przechowywania.
To szkolenie prowadzone przez instruktora na żywo w Koszalin (online lub na miejscu) jest skierowane do programistów, którzy chcą wykorzystywać i integrować Spark, Hadoop i Python do przetwarzania, analizy i transformacji dużych i złożonych zbiorów danych.
Pod koniec szkolenia uczestnicy będą mogli:
Skonfigurować niezbędne środowisko do rozpoczęcia przetwarzania dużych zbiorów danych za pomocą Spark, Hadoop i Python.
Zrozumieć funkcje, główne komponenty i architekturę Spark i Hadoop.
Nauczyć się, jak integrować Spark, Hadoop i Python do przetwarzania dużych zbiorów danych.
Poznać narzędzia w ekosystemie Spark (Spark MlLib, Spark Streaming, Kafka, Sqoop, Kafka i Flume).
Budować systemy rekomendacji oparte na filtrowaniu współpracującym, podobne do tych używanych przez Netflix, YouTube, Amazon, Spotify i Google.
Wykorzystać Apache Mahout do skalowania algorytmów uczenia maszynowego.
To prowadzone przez instruktora szkolenie na żywo w Koszalin obejmuje zaawansowane techniki Big Data, obliczenia rozproszone i uczenie maszynowe na dużą skalę. Jest przeznaczone dla zaawansowanych specjalistów ds. danych, którzy chcą opanować analitykę czasu rzeczywistego, integrację uczenia głębokiego i solidne strategie zarządzania danymi.
To szkolenie prowadzone przez instruktora na żywo w Koszalin (online lub na miejscu) jest skierowane do średniozaawansowanych specjalistów IT, którzy chcą zdobyć kompleksową wiedzę na temat IBM DataStage z perspektywy zarówno administracyjnej, jak i programistycznej, umożliwiając im skuteczne zarządzanie i wykorzystywanie tego narzędzia w swoich miejscach pracy.
Po zakończeniu szkolenia uczestnicy będą w stanie:
Zrozumieć podstawowe koncepcje DataStage.
Nauczyć się, jak skutecznie instalować, konfigurować i zarządzać środowiskami DataStage.
Łączyć się z różnymi źródłami danych i efektywnie ekstrahować dane z baz danych, plików płaskich i źródeł zewnętrznych.
Trening prowadzony przez instruktora w języku Koszalin (online lub stacjonarnie) jest przeznaczony dla administratorów systemów od poziomu początkującego do średniozaawansowanego, którzy chcą wdrożyć, utrzymywać i optymalizować klastry Spark.
Na zakończenie szkolenia uczestnicy będą potrafili:
Instalować i konfigurować Apache Spark w różnych środowiskach.
Zarządzać zasobami klastra oraz monitorować aplikacje Spark.
Optymalizować wydajność klastrów Spark.
Wdrażać mechanizmy bezpieczeństwa i zapewniać wysoką dostępność.
Diagnostykować i rozwiązywać typowe problemy związane ze Sparkiem.
W tym prowadzonym przez instruktora, żywym szkoleniu w Koszalin, uczestnicy dowiedzą się, jak korzystać z Pythona i Sparka jednocześnie do analizy dużych zbiorów danych, pracując nad ćwiczeniami praktycznymi.
Na zakończenie tego szkolenia uczestnicy będą potrafili:
Poznać sposoby użycia Sparka z Pythonem do analizy dużych zbiorów danych.
Wykonać ćwiczenia symulujące przypadki z rzeczywistego świata.
Stosować różne narzędzia i techniki do analizy dużych zbiorów danych za pomocą PySpark.
Poznaj Big Data BI dla agencji rządowych w Koszalin. Ten kurs obejmuje Hadoop, NoSQL, analitykę predykcyjną i narzędzia czasu rzeczywistego do zarządzania ogromnymi, zróżnicowanymi strumieniami danych. Naucz się wykrywania nadużyć, cyberbezpieczeństwa i strategii ROI, aby przekształcić dane nieustrukturyzowane w zasoby strategiczne dla sukcesu misji.
Podczas tego szkolenia prowadzonego przez instruktora w Koszalin, uczestnicy nauczą się, jak podejść do technologii Big Data, ocenić ich wpływ na istniejące procesy i polityki oraz wdrożyć te technologie w celu identyfikacji działalności przestępczej i zapobiegania przestępczości. Przeanalizowane zostaną studia przypadków z organizacji ścigania na całym świecie, aby uzyskać wgląd w ich podejścia do adopcji, wyzwania i wyniki.
Pod koniec szkolenia uczestnicy będą mogli:
Połączyć technologię Big Data z tradycyjnymi procesami gromadzenia danych, aby złożyć w całość historię podczas śledztwa.
Wdrożyć przemysłowe rozwiązania do przechowywania i przetwarzania dużych zbiorów danych do analizy danych.
Przygotować propozycję adopcji najbardziej odpowiednich narzędzi i procesów umożliwiających podejście oparte na danych w śledztwach kryminalnych.
Poznaj podstawy programowania z Big Data w R, języku popularnym w finansach. Ten kurs w Koszalin obejmuje konfigurację środowiska, MPI do przetwarzania równoległego oraz macierze rozproszone. Naucz się obsługiwać duże zbiory danych, wykonywać regresję rozproszoną i efektywnie stosować metody Monte Carlo.
To stacjonarne szkolenie w Koszalin przybliża podstawy Big Data i jego rolę w świecie biznesu. Uczestnicy będą pracować na przykładach komputerowych i wykonywać ćwiczenia typu case study z wykorzystaniem odpowiednich narzędzi do przetwarzania dużych zbiorów danych, obejmujących Hadoop, Spark i technologie magazynowania danych.
Trening prowadzony przez instruktora (online lub stacjonarny) skierowany jest do inżynierów danych, analityków oraz profesjonalistów działających w obszarze danych, którzy chcą korzystać z Databricks i PySpark do budowania skalowalnych potoków danych oraz migracji istniejących przepływów pracy opartych na SQL.
W Koszalin to pięciodniowe szkolenie wprowadza w systemy strumieniowania danych w czasie rzeczywistym. Obejmuje ono podstawowe koncepcje, wzorce architektoniczne oraz narzędzia branżowe do przetwarzania ciągłych danych na dużą skalę. Uczestnicy uczą się projektowania, wdrażania i optymalizacji skalowalnych potoków strumieniowych z wykorzystaniem nowoczesnych frameworków.
To szkolenie na żywo z instruktorem w Koszalin jest przeznaczone dla administratorów na poziomie średnio zaawansowanym, którzy chcą wdrażać Apache NiFi w środowisku produkcyjnym i nim zarządzać. Uczestnicy nauczą się konfigurować klastry, projektować przepływy danych i optymalizować wydajność dzięki laboratoriom praktycznym i ćwiczeniom opartym na scenariuszach.
Szkolenie to zapewnia praktyczne wprowadzenie do budowania skalowalnych procesów przetwarzania danych i przepływów pracy w zakresie uczenia maszynowego przy użyciu PySpark. Uczestnicy dowiedzą się, jak Apache Spark działa w ramach nowoczesnych ekosystemów Big Data oraz jak efektywnie przetwarzać duże zbiory danych, korzystając z zasad obliczeń rozproszonych.
Ten trzudniowy, praktyczny kurs koncentruje się na budowaniu i optymalizacji wydajnych obciążeń przetwarzania danych przy użyciu PySpark, Pandas oraz Polars w środowiskach opartych na Kubernetesie.
Uczestnicy zdobędą praktyczną wiedzę na temat tego, jak aplikacje Spark są wykonywane w Kubernetesie oraz jak decyzje dotyczące konfiguracji na poziomie aplikacji wpływają na wydajność, skalowalność, zużycie zasobów i koszty. Kurs obejmuje kluczowe obszary optymalizacji, takie jak rozmiar executorów, alokacja pamięci, dynamiczna alokacja, strategie partycjonowania, zachowanie shuffle, problem małych plików oraz wydajne przetwarzanie formatu Parquet.
Kurs porusza również typowe wyzwania związane z pracą w Pandasie, w tym ograniczenia pamięci i błędy przekroczenia pamięci (out-of-memory), wprowadzając Polarsa jako wysokowydajną alternatywę dla wybranych zadań przetwarzania danych. Dzięki ćwiczeniom praktycznym uczestnicy nauczą się diagnozować problemy z wydajnością i pamięcią, porównywać różne strategie konfiguracyjne oraz stosować techniki optymalizacji w realistycznych scenariuszach ETL i uczenia maszynowego.
Przez cały kurs kładziemy nacisk na praktyczne podejmowanie decyzji: rozumienie sposobów identyfikowania wąskich gardeł, wybierania odpowiednich narzędzi, efektywnej konfiguracji Sparka oraz utrzymywania równowagi między wydajnością a zużyciem zasobów infrastruktury i kosztami.
To szkolenie prowadzone przez instruktora na żywo w Koszalin (online lub na miejscu) jest skierowane do inżynierów, którzy chcą skonfigurować i wdrożyć system Apache Spark do przetwarzania bardzo dużych ilości danych.
Pod koniec szkolenia uczestnicy będą mogli:
Zainstalować i skonfigurować Apache Spark.
Szybko przetwarzać i analizować bardzo duże zbiory danych.
Zrozumieć różnicę między Apache Spark a Hadoop MapReduce oraz kiedy używać którego z nich.
Zintegrować Apache Spark z innymi narzędziami do uczenia maszynowego.
To praktyczne szkolenie w Koszalin wyjaśnia Apache Spark, obejmując RDD, DataFrame oraz API Pythona i Scali. Uczestnicy opanują wdrażanie w chmurze z Databricks, AWS EMR i Glue, budując praktyczne umiejętności potrzebne do efektywnej pracy w inżynierii danych i DevOps.
To szkolenie prowadzone przez instruktora, na żywo w Koszalin (online lub na miejscu) jest skierowane do osób technicznych, które chcą wdrożyć Talend Open Studio for Big Data w celu uproszczenia procesu odczytywania i przetwarzania dużych zbiorów danych.
Po zakończeniu szkolenia uczestnicy będą mogli:
Zainstalować i skonfigurować Talend Open Studio for Big Data.
Połączyć się z systemami Big Data, takimi jak Cloudera, HortonWorks, MapR, Amazon EMR i Apache.
Zrozumieć i skonfigurować komponenty i złącza Big Data w Open Studio.
Skonfigurować parametry do automatycznego generowania kodu MapReduce.
Wykorzystać interfejs typu drag-and-drop w Open Studio do uruchamiania zadań Hadoop.
Tworzyć prototypy potoków danych Big Data.
Automatyzować projekty integracji danych Big Data.
Więcej...
Ostatnia aktualizacja:
Opinie uczestników (6)
Podróż przez świat Sparka: bardzo intensywny kurs. DSL, Spark SQL, partycjonowanie a bukowanie dla mnie.
Georgiana Elisabeta
Szkolenie - Apache Spark Fundamentals
Przetłumaczone przez sztuczną inteligencję
praktyki
Liliana Padilla - Hipodromo de Agua Caliente
Szkolenie - Greenplum Architecture and Data Modeling
Przetłumaczone przez sztuczną inteligencję
Ćwiczenia praktyczne. Kurs powinien trwać 5 dni, ale 3 dni pomogły rozstrzygnąć wiele pytań, które miałem związanymi z pracą w NiFi.
James - BHG Financial
Szkolenie - Apache NiFi for Administrators
Przetłumaczone przez sztuczną inteligencję
Zdolność trenera do dostosowania kursu do wymagań organizacji, a nie tylko do zapewnienia jego przeprowadzenia dla samego siebie.
Masilonyane - Revenue Services Lesotho
Szkolenie - Big Data Business Intelligence for Govt. Agencies
Przetłumaczone przez sztuczną inteligencję
Szkolenie było prowadzone w ciekawy i profesjonalny sposób, co pozwoliło na usystematyzowanie i poszerzenie wiedzy z zakresu tematu szkolenia. Prowadzący wykazał się dużym doświadczeniem i umiejętnością przekazywania informacji. Szkolenie było bardzo praktyczne i dostosowane do naszych potrzeb. Polecam
Dominik Kozlowski - Shell Polska
Szkolenie - Big Data - Data Science
Fakt, że mogliśmy zabrać ze sobą większość informacji/kursu/prezentacji/zadań, które wykonaliśmy, dzięki czemu możemy się nimi przyjrzeć i ewentualnie powtórzyć to, co nie zrozumieliśmy od razu, lub poprawić to, co już zrobiliśmy.
Raul Mihail Rat - Accenture Industrial SS
Szkolenie - Python, Spark, and Hadoop for Big Data
Szkolenie Big Data Koszalin, szkolenie wieczorowe Big Data Koszalin, szkolenie weekendowe Big Data Koszalin, Big Data boot camp Koszalin, kurs zdalny Big Data Koszalin, Trener Big Data Koszalin, kurs online Big Data Koszalin, wykładowca Big Data Koszalin, instruktor Big Data Koszalin, lekcje Big Data Koszalin, Kurs Big Data Koszalin, Kursy Big Data Koszalin, nauczanie wirtualne Big Data Koszalin, nauka przez internet Big Data Koszalin, edukacja zdalna Big Data Koszalin