Szkolenia Apache Hadoop na żywo, online lub w siedzibie klienta, prowadzone przez instruktora, pokazują poprzez interaktywne ćwiczenia praktyczne podstawowe komponenty ekosystemu Hadoop oraz sposoby wykorzystania tych technologii do rozwiązywania problemów na dużą skalę.
Szkolenia Hadoop są dostępne w formie „szkolenia na żywo online” lub „szkolenia na żywo w siedzibie klienta”. Szkolenie na żywo online (inaczej „zdalne szkolenie na żywo”) odbywa się za pośrednictwem interaktywnego pulpitu zdalnego. Szkolenie na żywo w siedzibie klienta może być prowadzone lokalnie w siedzibie klienta w Trójmiasto lub w centrach szkoleniowych NobleProg w Trójmiasto.
NobleProg — Twój lokalny dostawca szkoleń
Gdynia
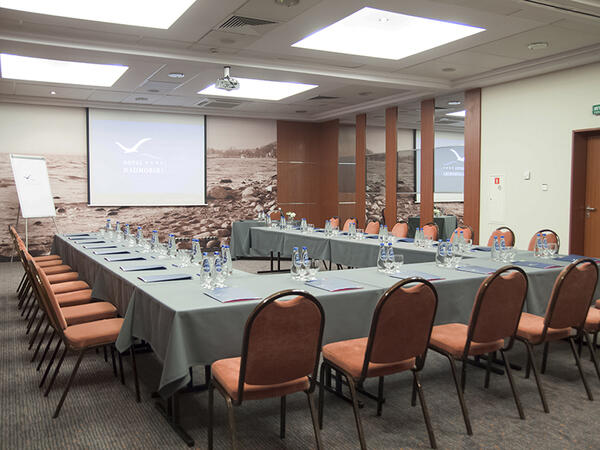
Hotel Nadmorski, Ejsmonda 2, Gdynia, Polska, 81-409
Sala szkoleniowa znajduje się zaledwie 3 kilometry od Dworca PKP/PKS w Gdyni, co sprawia, że jest łatwo dostępna dla uczestników podróżujących pociągiem lub autobusem. Dodatkowo, jest oddalona tylko o 400 metrów od przystanku autobusowego, ułatwiając dojazd nawet tym, którzy podróżują komunikacją miejską. Wyposażona jest w niezbędne narzędzia do prowadzenia szkoleń, takie jak rzutnik, ekran oraz flipchart, co zapewnia komfortowe warunki dla uczestników i prowadzącego zajęcia.
Gdańsk
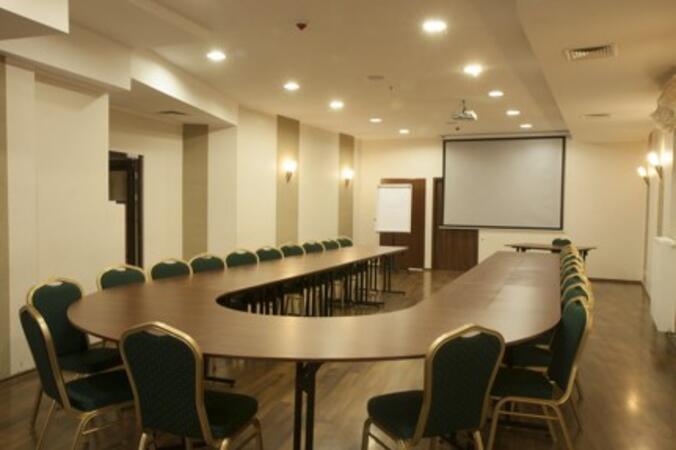
Hotel Fahrenheit, Grodzka 19, Gdańsk, Polska, 80-841
Sala szkoleniowa znajduje się w samym sercu malowniczej gdańskiej starówki, co sprawia, że otoczenie jest nie tylko inspirujące, ale także wyjątkowo atrakcyjne dla uczestników. W niedalekiej odległości można znaleźć dworzec PKP oraz PKS, ułatwiając przyjazd zarówno tym podróżującym pociągiem, jak i autobusem. Dodatkowo, lotnisko i port są również w zasięgu ręki, co czyni tę lokalizację wygodną dla osób przybywających z dalszych miejscowości, zarówno z kraju, jak i spoza jego granic.
To szkolenie prowadzone przez instruktora na żywo w Trójmiasto (online lub na miejscu) jest skierowane do programistów, którzy chcą wykorzystywać i integrować Spark, Hadoop i Python do przetwarzania, analizy i transformacji dużych i złożonych zbiorów danych.
Pod koniec szkolenia uczestnicy będą mogli:
Skonfigurować niezbędne środowisko do rozpoczęcia przetwarzania dużych zbiorów danych za pomocą Spark, Hadoop i Python.
Zrozumieć funkcje, główne komponenty i architekturę Spark i Hadoop.
Nauczyć się, jak integrować Spark, Hadoop i Python do przetwarzania dużych zbiorów danych.
Poznać narzędzia w ekosystemie Spark (Spark MlLib, Spark Streaming, Kafka, Sqoop, Kafka i Flume).
Budować systemy rekomendacji oparte na filtrowaniu współpracującym, podobne do tych używanych przez Netflix, YouTube, Amazon, Spotify i Google.
Wykorzystać Apache Mahout do skalowania algorytmów uczenia maszynowego.
To szkolenie na żywo z instruktorem w Trójmiasto jest przeznaczone dla administratorów na poziomie średnio zaawansowanym, którzy chcą wdrażać Apache NiFi w środowisku produkcyjnym i nim zarządzać. Uczestnicy nauczą się konfigurować klastry, projektować przepływy danych i optymalizować wydajność dzięki laboratoriom praktycznym i ćwiczeniom opartym na scenariuszach.
Więcej...
Ostatnia aktualizacja:
Opinie uczestników (2)
Ćwiczenia praktyczne. Kurs powinien trwać 5 dni, ale 3 dni pomogły rozstrzygnąć wiele pytań, które miałem związanymi z pracą w NiFi.
James - BHG Financial
Szkolenie - Apache NiFi for Administrators
Przetłumaczone przez sztuczną inteligencję
Fakt, że mogliśmy zabrać ze sobą większość informacji/kursu/prezentacji/zadań, które wykonaliśmy, dzięki czemu możemy się nimi przyjrzeć i ewentualnie powtórzyć to, co nie zrozumieliśmy od razu, lub poprawić to, co już zrobiliśmy.
Raul Mihail Rat - Accenture Industrial SS
Szkolenie - Python, Spark, and Hadoop for Big Data